Apache Pinot
Apache Pinot ist eine verteilte OLAP-Datenbank für Analysen auf laufend eintreffenden Ereignissen. Sie passt, wenn eine Anwendung viele gleichzeitige, selektive Abfragen auf frische Ereignisdaten stellt und du den Streaming-Pfad samt Cluster betreiben kannst. Für einen kleinen täglichen Bericht mit wenigen Nutzern ist der Aufwand oft schwer zu rechtfertigen. Dieses Profil ordnet die Apache-Dokumentation ein; wir haben Pinot für diesen Artikel nicht selbst ausgeführt oder gemessen.
Profil auf einen Blick
- Preis und Abrechnung
- Open-Source-Kern ohne Produktlizenzgebühr; Infrastruktur und Betrieb separat
- Kostenlos nutzbar
- Apache License 2.0 für den Kern; Cloud separat
- Hosting und Region
- Selbstbetrieb möglich; Region, Backups und Zusatzdienste im konkreten Setup prüfen
- Sprache und Support
- Herstellerdokumentation überwiegend Englisch; deutschen Support nicht bestätigt
- Datenanbindung
- Konkreten Importweg und SQL-/BI-Client in der gewählten Version abnehmen
- Wichtige Grenze
- Partitionierung, Vergleichsspalte und Löschaufbewahrung für Upserts festlegen.
- Vor der Auswahl prüfen
- Gemeinsamen Korrektur-, Lösch- und Replay-Fall mit exakten Schlüsseln nachweisen.
Herstellerangaben geprüft am 26.10.2026. Kein eigener Praxistest. Primärquelle beim Anbieter. Nicht bestätigte Angaben sind ausdrücklich gekennzeichnet.
Wann Apache Pinot passt – und wann ein kleineres Setup reicht
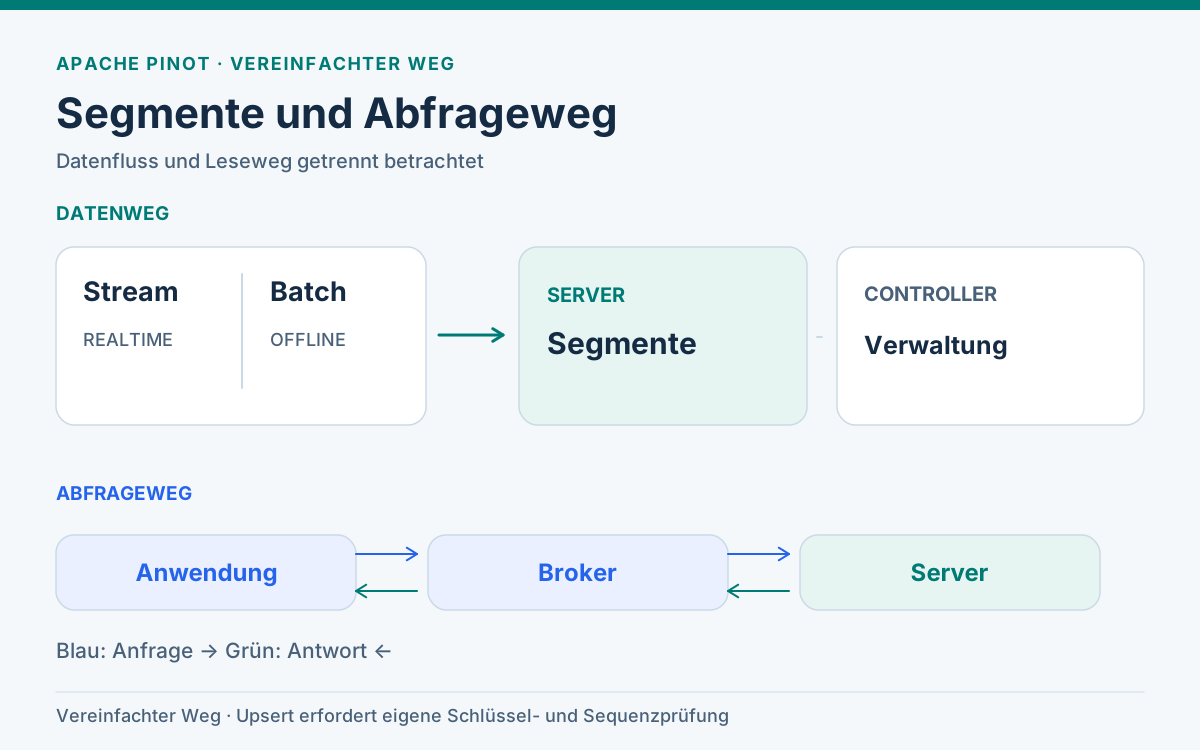
Pinots Stärke ist die Abfrage von Ereignissen aus einem Stream: etwa Klicks, Gerätesignale oder Produktnutzung, gefiltert nach Zeit, Mandant und Merkmalen. Ein Broker verteilt die Abfrage an die zuständigen Server und führt Ergebnisse zusammen. Dadurch kannst du für interaktive Anwendungen Frische und viele parallele Leseanfragen planen. Ein konkretes Latenz- oder Durchsatzziel folgt daraus noch nicht: Indexe, Datenverteilung, Query-Form und Hardware entscheiden. Die Apache-Clusterbeschreibung nennt Controller, Broker, Server, ZooKeeper und optional Minions als eigene Komponenten.
Plane Pinot, wenn die Anwendung sekundennah aktualisierte Ereigniskennzahlen braucht, einzelne Abfragen selektiv sind und du Kafka oder einen vergleichbaren Stream samt Monitoring schon verantworten kannst. Wenn ein nächtlicher Import und einige Analystenabfragen reichen, prüfe zuerst ein vorhandenes SQL-Warehouse oder eine kleine lokale Lösung wie DuckDB. Das spart potenziell Koordination, Datenkopien und laufenden Clusterbetrieb. Für die Einordnung gegenüber anderen OLAP-Systemen nutze den OLAP-Datenbankvergleich; die Grundbegriffe stehen bei OLAP.
Wie Architektur und Datenfrische zusammenhängen
Pinot speichert Daten in Segmenten. Die REALTIME-Tabelle konsumiert einen Stream; eine OFFLINE-Tabelle erhält fertig erzeugte Segmente aus einem Batch-Prozess. Eine HYBRID-Tabelle verbindet beide unter einem logischen Namen. Dabei trennt eine Zeitgrenze die Abfragebereiche: historisch liegende Bereiche können aus OFFLINE-, jüngere aus REALTIME-Segmenten kommen. Das ist nützlich, wenn bereinigte historische Daten einen frischen, weniger aufbereiteten Stream ergänzen. Überlappungen, Lücken und späte Ereignisse musst du am Übergang prüfen. Apache: Tabellenarten, Hybrid-Playbook.
„Echtzeit“ bedeutet hier einen kontinuierlichen Verarbeitungsweg, keine zugesicherte Zahl von Sekunden. Miss getrennt Quellzeit, Eingang im Stream, Consumer-Lag, Sichtbarkeit in Pinot und Antwortzeit der Abfrage. Eine niedrige Query-Latenz kann einen gestoppten CDC-Connector verdecken. Prüfe außerdem, ob Segment-Flush, Retention und Backfill eine historische Korrektur sichtbar halten. Für hohe parallele Last skalierst du unter anderem Broker und Server; die Broker-Dokumentation beschreibt den Zusammenhang zwischen Brokerzahl und Query-Parallelität, ersetzt aber keinen Test mit deinem Daten- und Filterprofil.
SQL, Joins und Modellierung: zwei Query-Wege unterscheiden
Pinot kann SQL-Aggregationen und Filter für operative Analysen bedienen. Für JOINs brauchst du laut Apache-SQL-Dokumentation die Multi-Stage Query Engine. Dort werden unter anderem INNER-, LEFT- und FULL-JOINs beschrieben. Das ist kein Versprechen, dass jede aus einem Warehouse übernommene SQL-Abfrage wirtschaftlich läuft. Der dokumentierte Hash-Join muss Daten verteilen und eine Hash-Tabelle aufbauen; große oder ungünstig verteilte Join-Eingaben können Speicher, Shuffle und Antwortzeit belasten. Die Operator-Dokumentation nennt explizit Grenzen und Speicherbedarf.
Modelliere häufig benötigte Merkmale gegebenenfalls vor dem Import in eine Ereignistabelle und halte große Dimensions-Joins als eigene Pilotfrage offen. Das ist eine Architekturentscheidung, keine Pflicht zum vollständigen Denormalisieren. Prüfe auch, ob die gewünschte Abfrage mit einem voraggregierten OLAP-Modell einfacher wird. Pinot ist eine Analytics-Schicht; für transaktionale Schreibvorgänge und referenzielle Geschäftsprozesse bleibt eine OLTP-Datenbank zuständig. Die Abgrenzung erklärt OLAP versus OLTP.
Updates, verspätete Ereignisse und Deletes präzise behandeln
Pinot bietet Upserts während der Ingestion. Nach der aktuellen Apache-Upsert-Dokumentation unterstützen REALTIME-Tabellen FULL und PARTIAL Upsert; OFFLINE und HYBRID unterstützen FULL, aber kein PARTIAL Upsert. In FULL ersetzt ein neues Ereignis die ganze logische Zeile. PARTIAL übernimmt nur ausgewählte Spalten nach konfigurierter Strategie. Plane die konkrete Tabellentype und Pinot-Version vor dem Pilot fest, denn Upsert-Konfigurationen wie Primärschlüssel und Vergleichsspalten lassen sich laut Dokumentation nach Erstellung nicht gefahrlos ändern.
Für korrektes Upsert müssen alle Ereignisse eines Primärschlüssels in derselben Stream-Partition landen. Eine comparisonColumns-Konfiguration entscheidet, welche Version gewinnt; ein bloßer Ereigniszeitstempel ist nur geeignet, wenn er fachlich streng genug ordnet. Bei gleichem Vergleichswert ist die Reihenfolge laut Apache nicht bestimmt. PARTIAL Upsert überspringt verspätete Ereignisse mit kleinerem Vergleichswert. Ein rückdatiertes, aber fachlich neueres CDC-Ereignis braucht daher eine monotone Quellsequenz oder eine andere verlässliche Ordnungsregel. Die deduplizierenden Metadaten liegen im Speicher und beeinflussen die Kapazitätsplanung. Quelle: Upsert-Anforderungen und Grenzen.
Das konfigurierte deleteRecordColumn blendet einen Schlüssel aus normalen Abfragen aus. Apache nennt dies ausdrücklich Soft Delete; bei einer späteren höheren Vergleichsversion kann der Schlüssel wieder erscheinen. Ein Datenschutz-Löschauftrag ist damit allein nicht vollständig erledigt: Segmentaufbewahrung, Deep Store, Backups, Replays und die Option skipUpsert gehören in ein eigenes Löschkonzept. Auch ein TTL für gelöschte Schlüssel muss verhindern, dass alte Updates nach Ablauf unerwünscht wieder sichtbar werden. Diese Grenzen sind für einen CDC-Pilot wichtiger als eine pauschale „Update unterstützt“-Markierung. Apache: Delete und TTL.
Für unseren Sollfall mit comparisonColumns: ["seq"] bleiben metadataTTL und deletedKeysTTL zunächst ungesetzt. Das ist eine Entscheidung für diesen Pilot: seq ist eine je Schlüssel steigende Versionsnummer und keine Zeitachse. Apache interpretiert die TTL-Werte in der Einheit der Vergleichsspalte; 86400 bedeutet hier deshalb nicht einen Tag. Eine spätere Bereinigung braucht eine gesondert geprüfte Aufbewahrungsregel einschließlich Replay, Compaction und Neustart. Apache: Metadata TTL, Deleted Keys TTL.
Lizenz, Betriebskosten und Zugriff
Der Apache-Pinot-Quellcode steht unter Apache License 2.0. Für selbst betriebenes Pinot fällt keine Softwarelizenz je Nutzer an. Kosten entstehen trotzdem für Broker, Server, Controller, ZooKeeper, Stream, dauerhafte Segmentspeicherung, Netzwerk, Überwachung, Sicherung und Personal. Ein kommerziell gehosteter Pinot-Dienst ist ein eigenes Angebot mit gesonderten Konditionen; aus der OSS-Lizenz lassen sich weder Cloud-Preis noch Hosting-Region ableiten. Vergleiche deshalb eine vollständige Monatsrechnung mit Replikation und Wiederanlauf, nicht nur den Preis eines Knotens.
Bei Apache-Pinot-Authentifizierung ist HTTP Basic Auth konfigurierbar, aber standardmäßig deaktiviert. Controller und Broker müssen passend geschützt werden. Die Basic-Auth-Dokumentation beschreibt Tabellen-ACLs; falls keine Tabellenliste gesetzt ist, sind für diesen Principal alle Tabellen zugänglich. API-Zugriff, Dienstkonten, TLS, interne Komponenten und Mandantenfilter gehören gesondert in die Abnahme. Der Aufstellungsort deiner Cluster, Streams, Backups und Dienste entscheidet über Datenflüsse; Open Source garantiert keine EU-Verarbeitung.
Synthetischer Event-/CDC-Fall als Abnahmematrix
Gemeinsamer synthetischer Sollfall, kein Produkttest: Der Schlüssel ist (tenant, id); seq steigt je Schlüssel. Zuerst stehen (nord,1) = 100 EUR, (nord,2) = 200 EUR und (sued,1) = 300 EUR: drei Zeilen und 600 EUR. Danach folgen (nord,1) mit seq=2 und 120 EUR, (nord,2) als Delete mit seq=2, (nord,3) neu mit 80 EUR sowie (sued,1) mit seq=2 und 350 EUR trotz älterer Ereigniszeit. Ein altes (nord,1,seq=1)-Ereignis folgt im Paket. Soll: nur (nord,1), (nord,3) und (sued,1), insgesamt 550 EUR (Nord 200 EUR, Süd 350 EUR). Ein exakter Replay ändert nichts; ein Tombstone muss (nord,2) vor einem später erneut gesendeten alten Ereignis schützen. Für Pinot muss der Stream nach dem zusammengesetzten Schlüssel partitioniert sein und comparisonColumns die fachliche Sequenz statt event_time nutzen. Die gemeinsame OLAP-Prüfvorlage enthält Eingaben, Sollwerte und leere Ergebnisfelder.
| Prüfung | Sollergebnis und Nachweis |
|---|---|
| Stream und Frische | Alle Versionen von (tenant,id) bleiben in derselben Partition; Quellzeit, Consumer-Lag und Sichtbarkeit getrennt protokollieren. |
| Korrektur und Replay | Start drei Zeilen/600 EUR; final drei Zeilen/550 EUR mit Nord 200 und Süd 350. (sued,1,seq=2) gewinnt trotz älterer Ereigniszeit; exaktes Replay und altes (nord,1,seq=1) ändern nichts. |
| Delete und Tombstone | (nord,2) ist unsichtbar; auch ein später gesendetes altes Nord-2-Ereignis belebt es nicht wieder. Rohsegmente, Backups und Löschfrist getrennt prüfen. |
| Query und Zugriff | Ein echter Nord-Leser sieht nur Nord 200 EUR und keine Süd-Zeile. Tabellen-ACL oder Mandantenarchitektur, Query-Latenz und Speicher unter geplanter Parallelität nachweisen. |
| Neustart und Historie | Nach Serverneustart dieselben Schlüssel und 550 EUR; ein OFFLINE-Backfill erzeugt weder Lücke noch Doppelzählung an der Hybrid-Zeitgrenze. |
Die Summe allein reicht als Beleg nicht: Zwei Fehler können sich aufheben. Vergleiche Schlüssel, Betrag, Sequenz, Löschstatus und Mandant einzeln. Die Schritte sind Anforderungen an einen späteren Test, keine beobachteten Pinot-Ergebnisse. Der gemeinsame OLAP-Prüffall bietet ein ausfüllbares Raster; bestehende Profile zu ClickHouse und DuckDB helfen bei der Auswahl anderer Betriebsgrößen.
Quellenstand und nächster Schritt
Quellenstand: 26.10.2026. Maßgeblich sind die verlinkten Apache-Seiten zu Architektur, Upsert und Delete, Joins, Zugriff sowie die Projektlizenz. Eigenschaften und Einstellungen sind vor Einführung an der gewählten Version zu bestätigen. Es gibt hier keine eigenen Leistungswerte und keine Affiliate-Partnerschaftsbehauptung; die BIS-Methodik beschreibt den Umgang mit Herstellerangaben.
Wenn du Pinot für ein konkretes Ereignisschema bewertest, beginne mit Datenfrische, Schlüsselverteilung, Korrekturen, Löschung und Leserrechten statt mit einer allgemeinen Benchmarkzahl. Für Auswahl und Einrichtung bietet die Schwesterseite BIC eine BI-Beratung an. BIS und BIC werden von Axel Schweizer betrieben; das wirtschaftliche Interesse erläutert Finanzierung.