DuckDB: analytische Datenbank für lokale BI
OLAP-Datenbanken · DuckDB · Herstellerquellen: 26.10.2026 · Eigene begrenzte dlt-/dbt-Prüfläufe: 10./19.10.2026 · Redaktion: Axel Schweizer
Profil auf einen Blick
- Preis und Abrechnung
- Open-Source-Kern ohne Produktlizenzgebühr; Infrastruktur und Betrieb separat
- Kostenlos nutzbar
- MIT-Lizenz für den Kern; eigener Betrieb
- Hosting und Region
- Selbstbetrieb möglich; Region, Backups und Zusatzdienste im konkreten Setup prüfen
- Sprache und Support
- Herstellerdokumentation überwiegend Englisch; deutschen Support nicht bestätigt
- Datenanbindung
- Konkreten Importweg und SQL-/BI-Client in der gewählten Version abnehmen
- Wichtige Grenze
- Prozess- und Schreibmodell vor Mehrnutzerbetrieb prüfen.
- Vor der Auswahl prüfen
- Gemeinsamen Korrektur-, Lösch- und Replay-Fall mit exakten Schlüsseln nachweisen.
Herstellerangaben geprüft am 26.10.2026. Kein eigener Praxistest. Primärquelle beim Anbieter. Nicht bestätigte Angaben sind ausdrücklich gekennzeichnet.
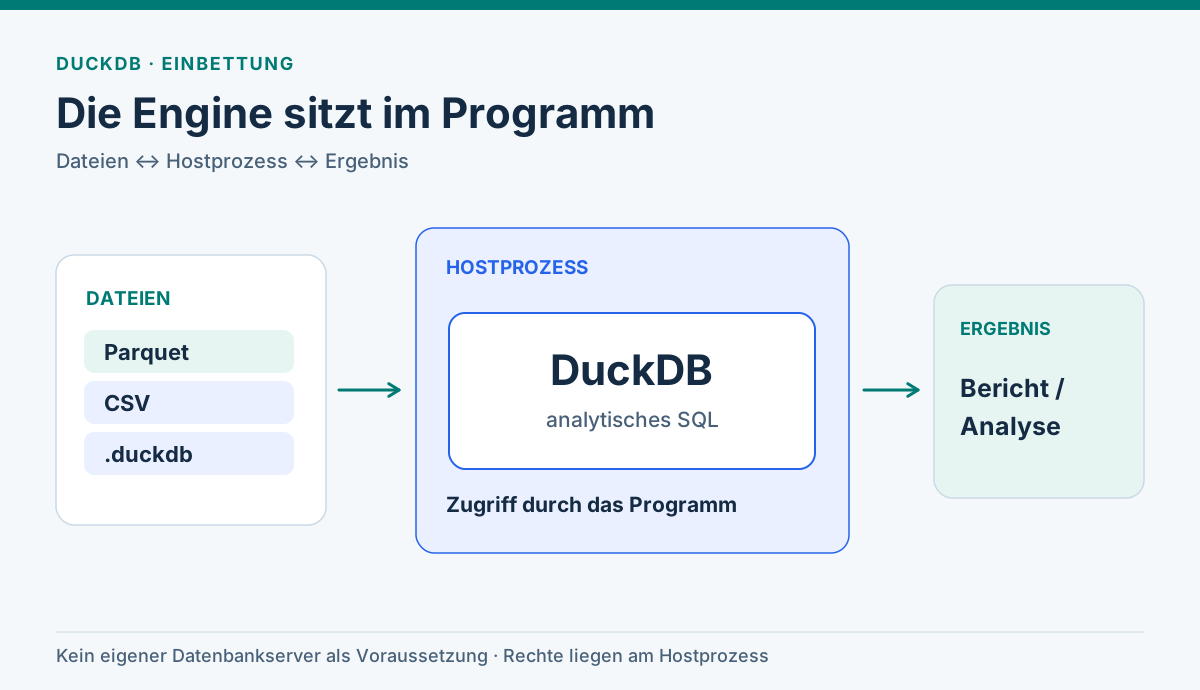
DuckDB ist eine analytische SQL-Datenbank, die im Prozess deiner Anwendung läuft. Du kannst Parquet-Dateien direkt auswerten oder Daten in einer lokalen DuckDB-Datei halten. Das ist eine starke Wahl für reproduzierbare Analysen, Datenaufbereitung und einen kleinen Reportingdienst mit kontrolliertem Zugriff. Die Grenze liegt beim Betriebsmodell: Gleichzeitige Leser und Schreiber, Rechte, Backups und Wiederanlauf musst du für deine konkrete Anwendung gestalten. Dieses Profil trennt dokumentierte Funktionen von zwei bereits veröffentlichten, eng begrenzten Praxistests.
DuckDB in einem Satz: analytische Arbeit ohne eigenen Datenbankserver
DuckDB verarbeitet analytische SQL-Abfragen spaltenorientiert und kann unter anderem lokale Parquet-Dateien abfragen. Der Kern steht unter MIT-Lizenz. Bei selbst betriebenem DuckDB fallen keine Produktlizenzgebühren an; Hardware, Speicher, Sicherung und Entwicklung bleiben reale Kosten. Ein Cloudangebot wie MotherDuck ist ein getrennt zu prüfender Dienst und gehört nicht zu diesem OSS-Urteil. DuckDB: Parquet, Repository-Lizenz.
| Anforderung | Einordnung | Abnahmefrage |
|---|---|---|
| Lokale Datenanalyse | Die Engine läuft im Python-, R-, CLI- oder Anwendungsprozess; Parquet kann direkt gelesen werden. | Ist das Ergebnis nach einem sauberen Neustart reproduzierbar? |
| Ein schreibender Dienst | Im eingebetteten Modus kann ein Prozess lesend und schreibend öffnen; mehrere Threads darin dürfen ohne Konflikt parallel schreiben. | Wer besitzt die Datei und koordiniert Laden, Abfragen und Backups? |
| Viele unabhängige Schreiber | Das klassische Dateimodell löst dies nicht allein. Quack und DuckLake sind eigene Architekturen mit eigenen Versions- und Betriebsfragen. | Ist ein dauerhaft erreichbarer Server oder ein zentraler Katalog tatsächlich nötig? |
Der OLAP-Datenbanken-Vergleich ordnet DuckDB neben ClickHouse, Apache Pinot und Apache Doris ein. Für die Begriffe dahinter helfen OLAP, OLAP-Würfel und OLAP vs. OLTP.
Ein Prozess, mehrere Threads – und die Grenze zwischen Prozessen
Im eingebetteten Lese-/Schreibmodus hält ein Prozess die Datenbank offen. Innerhalb dieses Prozesses erlaubt DuckDB gleichzeitige Verbindungen und Schreiber-Threads. Anhängen von Zeilen kann parallel laufen; ändern zwei Transaktionen dieselben Zeilen, kann eine mit Schreibkonflikt scheitern und muss kontrolliert wiederholt werden. Alternativ können mehrere Prozesse dieselbe Datei nur lesend öffnen, solange keiner schreibt. Dateisperren sind gerade auf gemeinsamem Netzspeicher sorgfältig zu prüfen. DuckDB 1.5: Concurrency.
Diese Aussage gilt bewusst für den klassischen eingebetteten Zugriff auf eine DuckDB-Datei. Die 1.5-Dokumentation nennt Quack für Mehrprozesszugriff in einer damaligen Betaphase sowie DuckLake mit zentralem PostgreSQL-Katalog als anderen Speicherweg. Die aktuelle 2.0-Dokumentation beschreibt Quack weiterentwickelt. Aus dem Vorhandensein dieser Wege folgt keine bereits geprüfte Eignung deiner Bibliothek, Anwendung oder Ausfallarchitektur. Halte Dateiformat, Engine-Version, Protokoll und Katalog im Pilot getrennt fest. DuckDB 1.5, aktuelle Concurrency-Dokumentation.
Für einen kleinen Berichtsdienst ist ein einzelner Prozess als Zugriffstor oft einfach: Er nimmt Ladejobs an, serialisiert konfliktreiche Schritte und gibt vorbereitete Ergebnisse an die Weboberfläche. Dies ist eine Architekturempfehlung, keine eingebaute Rollen- oder Webserverfunktion von DuckDB. Wenn viele eigenständige Nutzer gleichzeitig SQL senden sollen, muss die Anwendung Rechte, Quoten und Eingaben selbst durchsetzen – oder du prüfst eine Serverdatenbank.
Scans, Joins und Korrekturen gehören zusammen
Spaltenspeicherung und parallele Ausführung begünstigen Filter, Gruppierungen und große Scans. DuckDB kann Parquet ohne vorgelagerten Import lesen. Bei großen Joins, Sortierungen, Fenstern und Aggregationen kann die Engine Zwischenergebnisse auf temporären Speicher auslagern. Das bedeutet nicht, dass jede Abfrage unabhängig von RAM und freiem Plattenplatz durchläuft: Mehrere speicherintensive Operatoren oder bestimmte Aggregate können weiterhin an Grenzen stoßen. Teste besonders hohe Gruppenzahlen, viele-zu-viele-Joins, breite Resultate und gleichzeitige Abfragen. DuckDB: größere Daten als RAM und Grenzen.
DuckDB 1.5 dokumentiert UPDATE und MERGE INTO einschließlich bedingter Updates und Deletes. Damit lässt sich ein Korrekturbatch umsetzen; die Datenbank entscheidet aber nicht automatisch, ob ein verspätetes Ereignis eine neuere Version überschreiben darf. Definiere einen stabilen Geschäftsschlüssel und eine verlässliche Sequenz. Ein Löschereignis benötigt eine explizite Regel. Besonders gefährlich ist WHEN NOT MATCHED BY SOURCE THEN DELETE, wenn die Quelle nur ein Teilbatch ist: Dann fehlen dort auch gültige Bestandszeilen. DuckDB 1.5: MERGE INTO.
Auch analytische Joins brauchen fachlich gleiche Schlüssel und Körnung. Eine normalisierte Kennung kann aus null Treffern einen brauchbaren Join machen; ein mehrfaches Kostenjournal kann dagegen eine Summe vervielfachen. Das sind Datenmodell- und Qualitätsfragen, keine Benchmarkaussagen über DuckDB. Vor einem Produktionsbericht prüfe Trefferquote, Eindeutigkeit je Schlüssel, Zeilenzahl vor und nach dem Join sowie Summen gegen die Quelle.
Installation, Sicherung und Sicherheitsgrenze
Für einen nachvollziehbaren lokalen Python-Pilot dokumentiert die offizielle Installation unter anderem pip install duckdb==1.5.6; die Version ist hier nur die Referenz der veröffentlichten BIS-Prüfläufe. Die Installationsseite führt inzwischen auch 2.0 auf. Pinne Version und Abhängigkeiten, statt einen alten Befund still auf eine neue Version zu übertragen. Prüfe bei einem Upgrade Dateikompatibilität, Extensions, Abfrageergebnisse und Rückweg.
DuckDB läuft mit den Rechten des Hostprozesses. SQL kann Dateien lesen und schreiben, Netzwerkfunktionen oder Extensions nutzen. Die Sicherheitsdokumentation für 1.5 behandelt fremdes SQL deshalb wie ausführbaren Code: Parameter für Werte, nur kontrollierte Abfragestrukturen, minimale Betriebssystemrechte, gegebenenfalls Container- oder Prozessisolation. Einstellungen für Threads, Speicher und temporären Platz begrenzen Ressourcen, ersetzen aber keine Isolation. Vergib auf Dateisystem- und Anwendungsebene getrennte Lese-/Schreibrechte und teste, was ein Leser tatsächlich erreichen kann.
Sichere die persistente Datenbank in einem definierten konsistenten Zustand; prüfe den Restore in einem anderen Verzeichnis und vergleiche danach Schlüssel, Summen und Schemas. Parquet-Quelldateien, externe Kataloge, Secrets und eigene Ladejobs brauchen eigene Sicherungsregeln. Ein bloß vorhandenes Backup ist noch kein belegter Wiederanlauf. Bei vertraulichen Daten gehören Dateipfad, Rechte, temporäre Dateien und eventuelle Remote-Extensions in die Datenschutzprüfung.
Synthetischer Reportingfall: Korrektur, Replay und Aggregation
Gemeinsamer synthetischer Sollfall, kein Produkttest: Der Schlüssel ist (tenant, id); seq steigt je Schlüssel. Zuerst stehen (nord,1) = 100 EUR, (nord,2) = 200 EUR und (sued,1) = 300 EUR: drei Zeilen und 600 EUR. Danach folgen (nord,1) mit seq=2 und 120 EUR, (nord,2) als Delete mit seq=2, (nord,3) neu mit 80 EUR sowie (sued,1) mit seq=2 und 350 EUR trotz älterer Ereigniszeit. Ein altes (nord,1,seq=1)-Ereignis folgt im Paket. Soll: nur (nord,1), (nord,3) und (sued,1), insgesamt 550 EUR (Nord 200 EUR, Süd 350 EUR). Ein exakter Replay ändert nichts; ein Tombstone muss (nord,2) vor einem später erneut gesendeten alten Ereignis schützen. Für DuckDB müssen Import, Versionsvergleich, Upsert und Tombstone in der eigenen SQL-/Anwendungslogik ausdrücklich festgelegt werden. Die gemeinsame Prüfvorlage macht denselben Fall für andere OLAP-Kandidaten vergleichbar.
| Schritt | Erwarteter Nachweis | DuckDB-spezifische Falle |
|---|---|---|
| Erstimport und Aggregation | Drei eindeutige (tenant,id)-Schlüssel, 600 EUR; Nord 300 und Süd 300. |
CSV-Typen und zusammengesetzte Join-Schlüssel vor der Summe kontrollieren. |
| Korrektur und Löschung | Nur (nord,1), (nord,3) und (sued,1), zusammen 550 EUR; Nord 200, Süd 350. Nord-2 bleibt nach Neustart gelöscht. |
Teilbatch nicht als vollständige Quelle für „nicht vorhanden = löschen“ ausgeben; Tombstone erhalten. |
| Exaktes Replay und alte Version | Gleiche Schlüssel, Werte und 550 EUR; alte Nord-1-/Nord-2-Ereignisse setzen nichts zurück. | MERGE benötigt eine fachliche Versionsbedingung je Schlüssel. |
| Fehler und Wiederanlauf | Fehlerhafte Batchzeile sichtbar ablehnen; intakten Zielstand beweisen; Restore und Nord-Lesergrenze separat prüfen. | Parser-, Lade- und Anwendungsschritt können unterschiedliche Fehlergrenzen haben. |
Ergänze einen Gleichsummenfall: Zwei falsche Einzelwerte können sich rechnerisch aufheben. Vergleiche deshalb Schlüssel und Werte zeilenweise, nicht nur SUM(betrag). Messe für deine Daten zusätzlich Einzellauf und gleichzeitige Leser während des Ladevorgangs; notiere Hardware, Version, Datenstand und Abfrageplan.
Was BIS bereits mit DuckDB tatsächlich beobachtet hat
Der 550-EUR-OLAP-Abnahmefall ist ein neuer, noch nicht mit DuckDB durchgeführter Prüfauftrag. Die folgenden veröffentlichten dlt-/dbt-Läufe mit 2.700 EUR verwenden andere synthetische Daten und sind getrennte historische Belege.
Auf ETL-Tools ist ein lokaler dlt-1.31.0-/DuckDB-1.5.6-Lauf mit vier synthetischen CSV-Dateien veröffentlicht. Der konkrete Merge verarbeitete die verspätete Korrektur, Löschung und das exakte Replay zum Sollstand 2.700 EUR. Ein zusätzlich konstruiertes älteres Teilpaket setzte jedoch zwei Werte zurück; der gewählte dlt-Merge bot in dieser Konfiguration keinen allgemeinen Schutz gegen ältere Versionen. Typisierung und Datei-Fehlerprüfung stammten aus unserem Adapter.
Das dbt-Profil dokumentiert einen zweiten begrenzten Lauf mit dbt Core 1.12.6, dbt-duckdb 1.11.0 und DuckDB 1.5.6. Eine eigene SQL-Sequenzregel hielt dort den Sollstand, während ein bewusst unzureichendes Zeitfiltermodell 4.500 EUR lieferte. Native dbt-Tests stoppten im geprüften Modellgraphen einen fehlerhaften Folgeschritt. Daraus folgt weder eine allgemeine Produktnote für DuckDB noch eine Aussage zu ClickHouse, DuckDB 2.0, hoher Parallelität oder Crash-Restore. Ein eigener profilspezifischer Gesamtvergleich wurde für diese Seite nicht durchgeführt.
Wann DuckDB genügt – und wann du weiter vergleichen solltest
Wenn Analysen in einem kontrollierten Prozess laufen, Daten lokal bleiben können und Lade- sowie Leserzugriffe klar orchestriert sind, ist DuckDB ein naheliegender Pilot. Wird ein zentraler Dienst mit vielen unabhängigen Abfrageclients, feingranularen Datenbankrechten, Replikation oder fortlaufender Ereignisaufnahme verlangt, vergleiche die Serverwege im OLAP-Hub anhand derselben Abnahme. Das ist keine Aussage, dass eine bestimmte Datenmenge „zu groß“ für DuckDB sei: Die Grenze entsteht aus Abfragen, Hardware, Ausfallschutz und Prozessmodell.
Für eine belastbare Kostenrechnung addiere Rechner/Cloud-Instanz, Speicher und temporären Platz, Backup/Restore, Monitoring, Entwicklungszeit und gegebenenfalls einen gehosteten Dienst. Die MIT-Lizenz allein macht eine produktive Lösung nicht kostenlos. Herstellerlinks in diesem Profil sind Quellen, keine Partnerlinks. BIS und die BIC-Beratung werden von Axel Schweizer betrieben; die wirtschaftliche Verbindung ist unter Finanzierung offengelegt.